MixTeX 可以把包含印刷体公式、中英文混排文字和简单表格的图片转换为可编辑 LaTeX,这个仓库的 Releases 提供了 macOS 安装包。
整理研究笔记时,公式难复制的地方往往不只是字符,而是结构:求和符号里的上下限、分式中的括号、矩阵和表格的对齐。OCR 可以先生成一份草稿,再由人对照原图校正。
MixTeX-Latex-OCR-MacOS Fork 自 RQLuo/MixTeX-Latex-OCR。识别模型来自上游;这个 Fork 提供 macOS 安装包,方便在 Mac 上使用。
从 Mac 专用发布页下载
打开 MixTeX-v3.2.4macOS,下载 MixTex.dmg。发布说明给出的安装方法是打开磁盘映像,再把应用拖入“应用程序”。
仓库通用 README 仍有 Windows 说明,例如 Win+V。它们不是 Mac 上的实际操作快捷键,不宜直接照搬。安装时应以 macOS 专用 Release 为入口。
发布页没有列出完整的 macOS 版本和芯片兼容清单。先在自己的 Mac 上打开应用,用一张清晰的公式截图试用,再决定是否用于日常工作。
从清晰的小范围截图开始
先选择一个公式,或一小块包含文字与公式的内容。裁切时保留上下标和公式边界,尽量避免相邻栏、过小字符与整页杂乱背景一起进入图片。
下图是项目提供的识别示例,可以用来了解输入图片和 LaTeX 结果的关系。
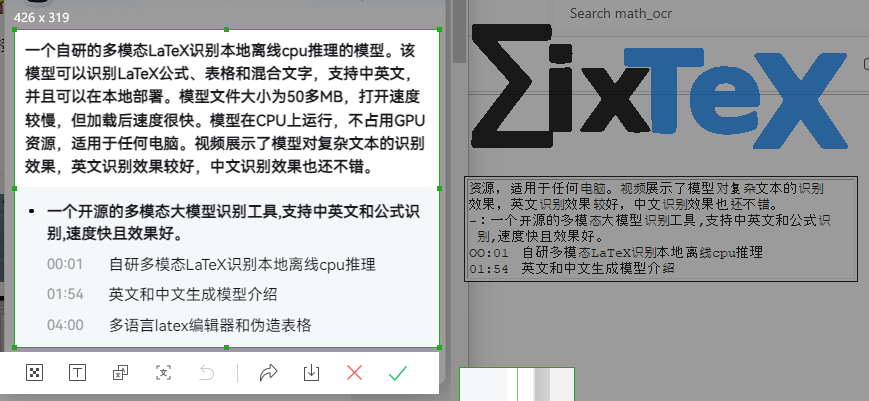
识别后,把 LaTeX 粘到临时文档中渲染,再和原图比较。能编译,只说明语法可以接受,不代表数学意思完全一致。
如果来源是论文 PDF,可以先把那一页转成图片,再裁出公式区域;不要把正文栏、页码和相邻公式一并塞进截图。识别完成后保留原图,并把生成的代码放进自己熟悉的 LaTeX 编辑器预览。这样发现 x_1 被读成 x_l 时,可以立刻回到原图核对,而不是等写进笔记后再猜。
在 Mac 上把截图送进剪贴板
这份图形界面通过剪贴板读取图片,并把识别后的 LaTeX 文本写回剪贴板。因此,实际流程是“复制图片 → 等待识别 → 粘贴代码”,不需要把 Windows 文档里的 Win+V 换成另一个键硬套。
可以在 Mac 上按住 Control、Shift、Command,再按 4,框选一个公式区域,把截图直接复制到剪贴板。先保持 MixTeX 运行,等待窗口输出完成,再切到编辑器按 ⌘V。若按的是普通 Shift-Command-4,截图通常保存成文件;只是在 Finder 选中这个文件再复制,剪贴板内容也未必是应用需要的图片数据。
第一次用最简单的一行公式验证这个过程。若没有输出,先确认剪贴板确实是图片,再看窗口是否显示模型加载或输入错误。模型还在初始化时,不要连续截很多张;等第一张得到文本后再换下一张,也方便知道每段代码对应哪张原图。程序会写回剪贴板,所以需要保留的旧剪贴板内容,应在开始前先存好。
把识别结果放进一份能独立编译的小文档
在已有论文模板里排错容易被其他设置干扰。可以先用下面这个最小例子检查数学环境,再把识别出的表达式替换到公式区域。中文文档可选择支持 ctexart 的 LaTeX 环境;只写英文的文档则可以使用普通 article。
|
|
把识别结果放进去以后,先看有没有重复的数学环境:如果文本本来带着 \[ ... \] 或 align*,就不要再机械地套进另一层独立公式。很多“无法编译”其实来自外层标记重复,而不是公式识别本身。
出现未定义命令时,看错误提示指向哪个命令,再核对它来自宏包、拼写还是识别错误。不要为了让编译继续就直接删除符号。先让最小文档正常显示,再回到自己的笔记或论文模板,问题通常更容易定位。
一页里有很多公式时,按逻辑拆开处理
双栏论文、矩阵和带推导过程的长公式,适合按完整表达式分块。裁得太紧可能切掉积分上下限,裁得太大又会把旁边的文字混进来。比较稳妥的范围是保留一个完整公式及必要标点,让每次结果都能和原图一一对应。
多行推导还要留意对齐关系和换行位置。左边的一项如果被识别到下一行,代码可能仍能编译,但读起来已经不是原来的等式。表格同样需要看行列对应,不只看每个数字是否认对。可以把原图和渲染预览并排,逐行检查完,再移入正式文档。
整理长期笔记时,最好保留论文名、页码和公式截图的来源。以后想修正一个下标或引用原推导,不必重新寻找整篇文献。识别工具节省的是手工录入时间,保留来源则让这份可编辑文本以后仍然可追溯。
检查数学含义,而不只是外观
负号、不等号、下标、希腊字母、括号与矩阵维度,都是容易出现“小改动、大影响”的地方。即使结果看起来很像原文,也要检查关键符号。
表格则需要逐行逐列对照。数字识别正确,却落到另一列,同样会改变结论。用于作业、论文或计算之前,最好把它当作辅助录入,而不是最终答案。
中文 README 明确提到,主要适合清晰印刷体、中英文混合公式和较简单的表格。手写公式和复杂表格尤其值得逐项核对。
本地推理与 LaTeX 环境
上游项目描述的是 CPU 本地推理,不需要为每张截图调用在线识别服务。不过,安装时仍可能需要获取应用、模型或依赖,不能把“离线推理”理解成整个安装过程不涉及下载。
渲染结果还需要合适的 LaTeX 环境。中文内容可参考 README 的 ctexart 示例,数学内容可能需要 amsmath、amssymb 等宏包。
原始材料在 PDF 中时,可以先用 PDF Page Extractor 导出页面图片。保留 PDF、截图和识别文本,后续校正会更有依据。识别限制见 中文 README。